系列上篇:AI 写代码之后,代码审查变成了什么:2026 年的行业现状
上一篇整理了 AI 代码审查的行业现状。这一篇写我自己目前的做法和判断。它不是结论,而是一条基线:我想把 2026 年的看法记下来,几年后回头对照。
核心问题:不是审不审,而是审哪里
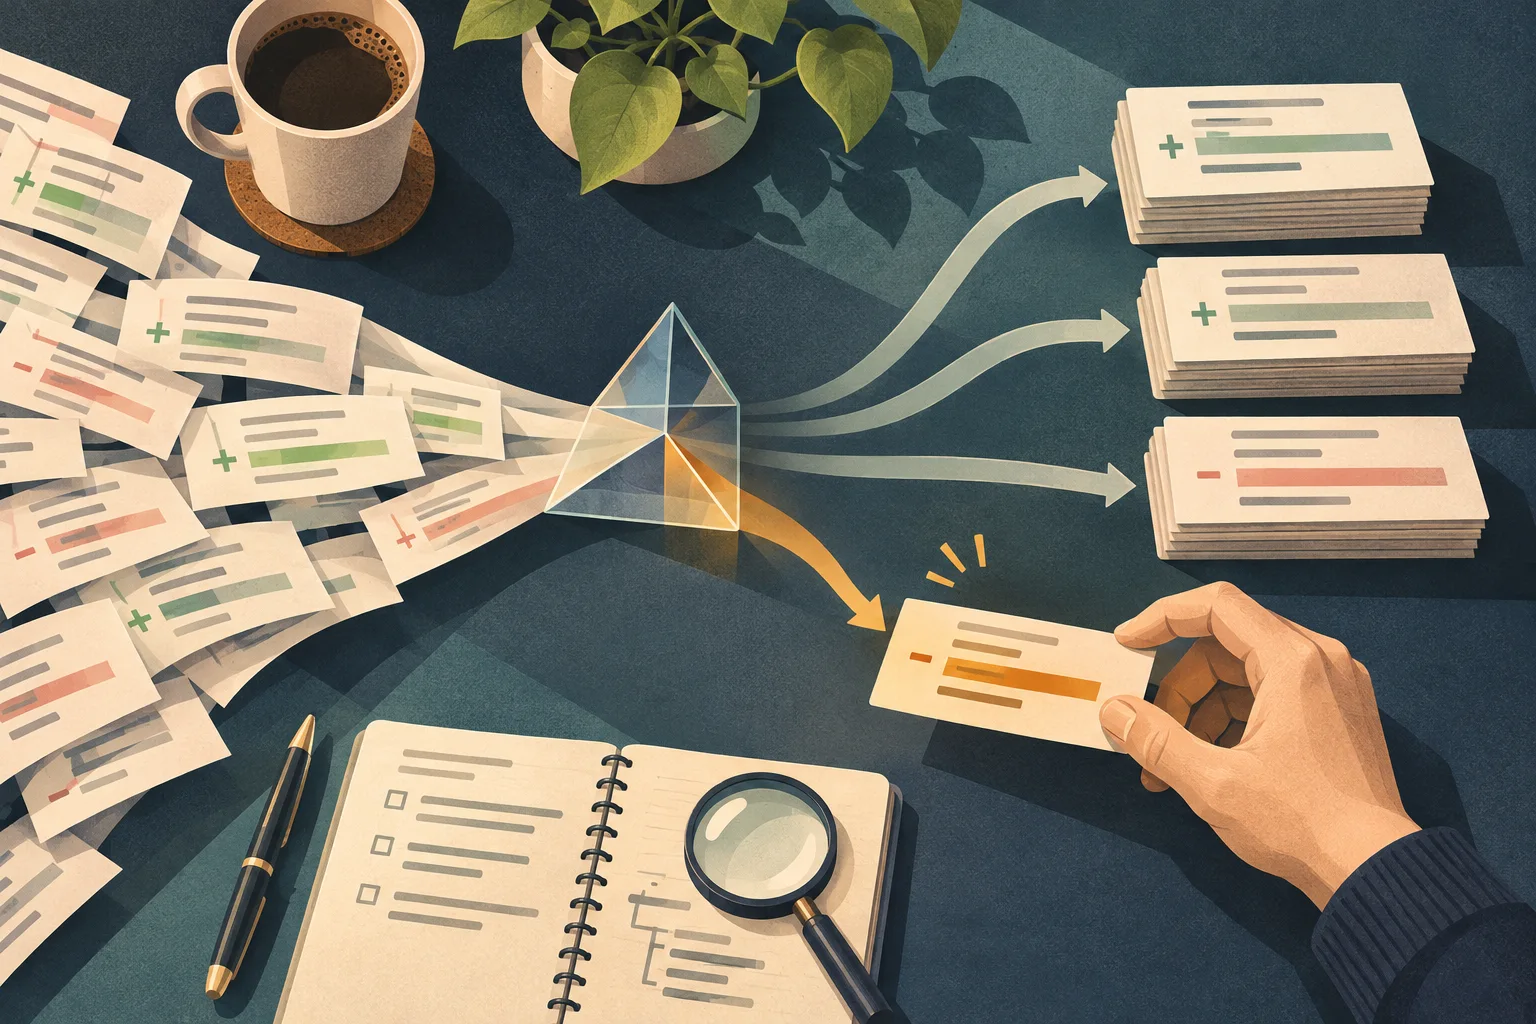
先把两头排除掉。 不能再像以前一样逐段理解代码,因为生成量太大了。AI 一天产出的代码,人认真读完要好几天,这条路在数量上就走不通。 也不能完全不审,因为会失控。上一篇里提到的那些案例,每个 PR 单独看都合理,合起来却把架构毁了;测试几乎全过,代码里却埋着上万个 unsafe 块。 所以我认为真正的问题是选择性 review:人的注意力有限,要花在最值得的地方。难点在于,怎么判断哪些地方需要重点审核。 我的回答分三步:把审查前移,让 AI 先做分诊,再由人根据分诊结果做选择。
先审设计,再由 AI 整理测试证据和风险,最后由人决定哪里值得细看。
一、把审查前移到意图和设计阶段
不要等代码产出了再开始审。 代码是最后的产物,也是体量最大、最难读的那一层。很多真正重要的错误,比如需求理解偏了、方案选错了、边界画错了,在意图(intent)和设计(design)阶段就已经发生了。到了代码层面,它们被几千行实现淹没,反而最难被看出来。 在意图和设计阶段审,审的东西少得多,改起来也便宜得多。这一步做扎实了,后面的代码审查才有一个可以对照的基准:这段代码是不是在做我们说好的事。 但前移也不是万能的。审查前移能在一定程度上守住架构,但我的看法是,即使没有 AI,只要团队人数变多、迭代速度变快,架构也很可能会慢慢变坏。至少在我们公司,系统维护不下去的时候,通常会做一次大的架构迁移,甚至重做一个新的 service。AI 可能会加快这个过程,但它不是唯一的原因。
二、让 AI 先做分诊
代码产出之后,先不要让人上,而是让 AI 做一轮初步判断。我希望它交出两类东西。
1. 能证伪的测试,而不是看起来很绿的测试
简单的 unit tests 不够,因为它们有欺骗性。agent 写的测试很可能只是在重复实现的逻辑,或者根本不可能失败。测试全绿,只说明测试本身被满足了,不说明代码是对的。 所以我要的是:
- mutation tests:故意把代码改坏,看测试会不会失败。测试抓不住这些变异,就说明它在走过场。
- e2e tests 加证据:从用户的角度把流程跑通,并且留下可以核对的记录,而不是一句“测试通过了”。 测试结果也不能全交给 AI 自己判断。尤其是 e2e 测试,人一定要扫一眼证据,比如录制的视频或截图。
2. 风险评估
让 AI 总结这次改动的风险画像:
- blast radius(爆炸半径):出了问题会影响多大范围,碰到了哪些主干代码、共享状态或对外接口。
- 是否容易回滚:有没有 feature flag 覆盖,出问题能不能一键关掉。
- 哪些地方风险高:需要人额外审核的具体位置,以及理由。
三、人根据分诊结果做选择性审查
有了测试证据和风险评估,人再决定看哪里、看多深。 碰到主干、回滚困难、或者被标为高风险的部分,要投入真正的注意力。至于低风险的改动能不能快速浏览甚至直接放行,我认为要看业务:快速迭代、出了事故影响也不大的环境,可以放得比较开;像支付这类一旦出错影响很大的业务,即使单个改动看起来风险不高,也应该更谨慎。 这里没有一个精确的公式,目标是尽量达到平衡:既不让人被海量代码淹没,也不让真正危险的改动溜过去。 这套机制本身也会出错。AI 分诊可能把高风险的改动判成低风险;写代码、写测试、做分诊的如果都是 AI,它们的盲区也可能重合。我的应对有两条:
- 规则的松紧同样看影响。 比如“自动分档只能往上调、不能往下降”“敏感路径必须有人看”,这些规则要多严格,取决于出问题的后果。影响有限、可以快速回滚的业务,可以适当放松;否则就要更严格。
- 不断完善团队的 review skill。 盲区一定会有,每次漏掉的问题都应该沉淀进团队的审查规则里,让下一次的分诊更准。
四、作者必须参与审查,但不能算审查者
上一篇提到一个行业分歧:发起提示、指挥 agent 写代码的人,算不算审查者?Anthropic 的 Claude Code 团队认为算,理由是谁发起改动谁就负责;Gitar/Sonar 的 Korlam 认为不算,理由是他和 agent 共享同一份上下文。 我的看法是:作者必须参与审查,但不算审查者。 为什么不算审查者? 有两个理由。 第一,最终责任归属于作者,而不是审查者。 既然责任已经在作者身上,审批名额就应该留给另一个人。有意思的是,Anthropic 用的也是责任这条原则,却得出了相反的结论:他们因为作者要负责,所以把作者算进审查者;我认为恰恰因为作者本来就要负责,他的批准不能再充当额外的那道关。 第二,作者审核自己的代码会有偏见,容易忽视错误。 这和审查 agent 不应该是写代码的那个 agent 是同一个道理。越来越多的团队已经接受 AI 不能自己审自己,因为它会被自己的生成过程锚定;人也一样。 为什么又必须参与? 因为作者知道的上下文比审查者多得多:为什么这样设计、试过哪些方案、哪里是故意的取舍。审查者有疑问时,作者能最快回答;审查意见也需要作者来回应和落实。作者参与,审查才高效。 所以作者的角色是:读证据、回答问题、回应审查意见、为结果负责,但不占一个批准名额。
五、说起来简单,做起来门槛不低
“让 AI 先做分诊”这一层,说起来只是一句话,真要落地并不容易。它至少需要:
- 团队维护的 skill 和 instructions:告诉 AI 这个代码库里什么算高风险、哪些路径敏感、团队的审查标准是什么。通用的 AI reviewer 不知道这些。
- AI 可以自主运行的基础设施:能自己跑 CI/CD,甚至能自己拉起环境跑 e2e 测试。没有这些,AI 只能读代码、猜结果,拿不出证据。 但这不意味着要等一切就绪才开始。我的建议是从门槛最低、收益最直接的地方做起:
- skill 和 instructions:把团队的审查经验写下来,让 AI 能用。
- 风险评估:让 AI 在每个 PR 上给出风险等级和理由。
- blast radius:让 AI 标出改动影响的范围和关键路径。 这几项不需要大规模改造基础设施,却能马上帮人决定该把注意力放在哪里。mutation tests、能自主运行的 e2e 测试这些更重的能力同样很重要,没有它们,AI 分诊就拿不出真正可信的证据;只是实现起来困难,不太容易一步到位,需要在前面这些基础上逐步建设。
结语
总结一下我目前的思考:
- 代码审查的核心问题不是审不审,而是审哪里;
- 审查要前移到意图和设计阶段;
- 让 AI 先分诊:给出能证伪的测试证据,评估爆炸半径和回滚难度,标出高风险点;
- 人根据分诊结果选择性审查,在效率和风险之间求平衡;
- 作者必须参与,但不算审查者;
- 落地门槛不低,但可以从 skill、instructions、风险评估和 blast radius 开始。 这是我在 2026 年的看法。工具和模型每隔几个月就换一代,几年后再回头看这篇文章,我最想知道的是哪一部分错了。
References
以下是本文借鉴或讨论的实践来源。“作者必须参与,但不占批准名额”以及具体分诊方案是我的判断,不是这些来源已经验证的行业结论。
- John Kim, How I Review AI Code
- Matt Pocock, Fixing the PR Bottleneck
- Addy Osmani, Morgan Westlee Lunt & Qing Wang, How the Claude Code Team Does Code Review
- Corey Gallon, I Believe Everything My Agents Tell Me: Three Levels of Review
- Gautam Korlam, Rebuilding CI for AI-Scale Commit Volume
- Dex Horthy × Patrick Akil, Why Coding Agents Keep Making Your Codebase Worse