系列下篇:AI 代码审查,我的思考:选择性 review,让 AI 先做分诊
AI 让写代码变得便宜之后,整个交付链条上最慢的那一环变成了审查。过去几个月我读了二十多份关于 AI 代码审查的演讲、文章和数据报告,这篇把它们整理成一张地图:问题出在哪里,大家在怎么做,哪些还没有答案。 先说一个前提:下面几乎所有材料都来自实践者的经验分享和厂商的数据,没有一份是对照实验。行业还在摸索,这篇文章记录的是 2026 年下半年的现状,不是结论。
一、数据:上游变快了,下游没跟上
几份 2025 到 2026 年的行业数据指向同一个反常现象:AI 采用率上升,缺陷和事故跟着上升,交付速度却没有变快。
- DORA 的生成式 AI 报告(2025 版,基于 2024 年研究):AI 采用率每提高 25%,交付稳定性估计下降约 7.2%。这是相关性估计,不能直接写成事故率上升,也不能据此认定 AI 导致了不稳定。
- Faros AI 对约 2.2 万名开发者、4000 个团队做了组织内前后对比:每个 PR 对应的事故数 +242.7%,审查时长中位数 +441.5%,PR 体积 +51.3%,没有任何人工或 agent 审查就合并的 PR 多了 31.3%。同时上游吞吐确实提高了,任务吞吐 +33.7%。但每周部署次数反而下降 11.7%,从提交到上线的时间增加 480%。需要注意,这两个下游指标只来自数据集中约 10% 有部署埋点的团队,Faros 自己也提醒提交到上线时间的团队间差异很大。
- Stack Overflow 2026 调查:在回答信任问题的 14,304 人中,48% 表示在容易验证输出时信任 AI,只有 6.6% 表示愿意在重要工作决策中信任它。这个指标衡量的是信任的条件,不能直接当作 AI 输出准确率。
- GitClear 2026 报告以 2023–2026 年约 6.23 亿次代码变更为分析背景:按每百万变更行归一化的重复代码块指标较 2023 年增长 81%;移动代码(用作重构代理指标)的占比从 2022 年的 21% 降到 2026 年截至报告时的 3.8%。这些是可维护性信号,不是对 AI 因果效应的直接测量。 Laurie Voss 在演讲里转述过一个更极端的数字:开启自主 agent 的开发者代码量多了 741%,交付的软件只多了 30%,瓶颈被点名为审查。这项研究在演讲中没有具名,我也没有核对原文,所以只当作一个方向性的信号。
二、为什么“读 diff”不管用了
传统的代码审查依赖一个很少被说出来的前提:审查者对系统有自己的理解,而这份理解来自他自己写过相邻的模块。审查的价值,就是审查者的心智模型和这段代码之间的差距。 当实现交给 AI 之后,这个前提有两种独立的崩塌方式。 第一,上下文没了。 如果审查者对系统的理解完全来自读这个 PR 本身,那他的心智模型和代码之间的差距就是零,审查不再产生信息。从这个角度看,很多 PR 无人审查就合并,不只是偷懒,而是审查动作本身已经空转了。 第二,读不过来。 Voss 引用了一项 Cisco 的老研究(约 2500 次审查、320 万行代码):一次读超过约 400 行,审查者就不再能有效发现缺陷。按这个速度,一个 1 万行的 agent PR 需要三到四个工作日的真正审查。这项研究早于 AI、针对的是人写的代码,搬到 agent 代码上是一个假设,但方向很难说是错的。 还有一个更根本的限制。Stellman(O’Reilly)讨论的是安全缺陷:他引用的经典区分认为,约一半是实现 bug,另一半是设计缺陷,例如漏掉鉴权约束或画错信任边界。只看代码结构、不知道系统应该保证什么,就容易漏掉后一类问题;这不能扩大成“所有缺陷都有一半无法检出”的普遍定律。
三、两个极端都有反例
面对这个困境,最直接的两种反应是“彻底不看”和“像以前一样逐行看”。两者都已经有了反例。 彻底不看。 Dex Horthy 曾经公开建议“别读代码”,半年后收回了这个建议,因为他停止阅读三个月的代码库遇到了任何提示都解决不了的问题。DHH 说 37signals 让设计师直接用 AI 写代码时,每个 PR 单独看都说得过去,合在一起却毁掉了系统架构,最后靠人工清理。Bun 用六天把百万行 Zig 移植到 Rust,现有测试通过率 99.8%,但代码里有 13044 个 unsafe 块,而一个可比的人写的 Rust 代码库只有约 74 个。 逐行看。 上面的数据已经说明了,人的注意力不随代码量增长。 值得注意的是,那些号称“不读代码”的成功案例,细看都不是真的放手。被放弃的是逐行阅读,人仍然掌握着测试、harness 和审查 agent 这些验证系统。
四、正在形成的做法
1. 按风险分配审查深度
这是收敛最明显的一点。不过,这种收敛主要发生在公开分享经验的实践者之间,实际采用率仍然很低。至少四个独立来源用不同的词汇说了同一件事:审查深度应当由爆炸半径(出错会影响多大范围)和可逆性(能不能轻松回滚)决定。
- Meta 的 John Kim 把代码库看成一棵树:主干代码(入口、共享状态、基础设施)逐行读;叶子代码(隔离的,或完全在 feature gate 后面的)对照附带的证据快速浏览。
- Matt Pocock 借用 AWS 的说法,把每个 PR 分成单向门和双向门,并在 PR 底部打印一行“合并危险度”。大多数 PR 是双向门;昂贵的迁移、数据丢失,或者一个看起来很小但可能给 6 万人发邮件的改动,是单向门,要“往死里审”。
- Kun Chen 的个人工作流在最后做一次风险评估,低风险改动直接跳过 diff 审查。
- Voss 总结行业实践发现,人工检查点保留下来的地方是:正确性不容易自动验证的、爆炸半径大的,以及必须有人签字负责的。
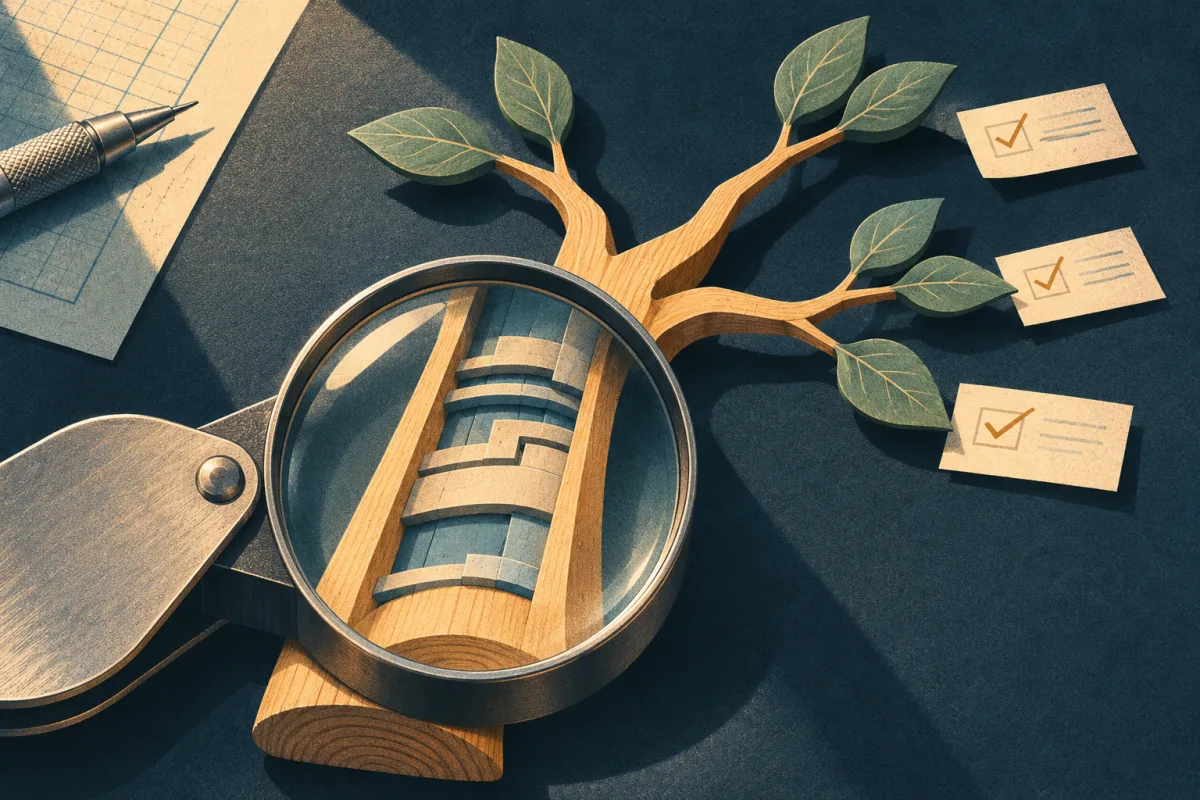
借用 John Kim 的树形比喻,改到共享主干就细读代码,孤立的叶子改动则对照验证证据。
Anthropic 的 Claude Code 团队给出了一个具体的政策形态。他们把风险档写成需要几个人批准:文档、文案、内部功能、feature flag 后面的增量改动不需要人;普通产品改动和缓存、自动更新、系统提示这类敏感区域需要一个人;风险最高的代码需要两个人。几条配套规则很有意思:
- 档位由分类器根据改动内容决定,不由作者决定;
- 第二个分类器只能给某个改动加人,不能减人;
- 所有者标记为敏感的路径,以及所有 CI 配置文件,永远需要人;
- agent 的批准永远不能顶替人的名额;
- 批准绑定到具体的 commit,有新提交进来就作废;
- 推行建议是“从严开始,有了证据再放松”。 这里有一个我觉得很重要的不对称:往下误判(把高风险当低风险)的代价远大于往上误判。所以自动分档可以抬高级别,但降级应该由人或一条明确有人负责的规则来做。 作为对照,WorkOS 的 Nick Nisi 提出过另一种尚未部署验证的设计:团队审查 skill、轻量分类器、商业审查工具三层级联,任何一层不通过就升级给人,全部通过就自动合并。区别在于它没有一个“无论各层怎么判,这类改动都必须有人看”的确定性底线。
2. 把审查 agent 当成独立的组件来设计
“让写代码的 agent 自己检查一遍”是不够的。几个来源总结出了审查 agent 自己的设计规则:
- 独立、全新的上下文。 带着生成过程上下文的 agent 会被之前的对话锚定。Corey Gallon 举过一个例子:起草 agent 自查时核对了合同里的每个日期,全部通过;两个全新上下文的审查者却独立发现了一条三年自动续约条款,合同三周前已经自动续约了,而起草 agent 在修改时恰好删掉了原本正确指出这一点的那句话。“原 agent 自己的检查,同意了它自己的错误。”
- 分开的上下文预算。 Pocock 的观察是:实现者的窗口要同时装下探索、修改和调试,已经过载,再塞编码规范只会更糟;审查者不需要实现和调试,窗口有余量,可以承载大量规范。所以团队的审查标准应该只给审查 agent 读。
- 默认怀疑,多遍审查。 Cursor 早期的审查器对每个 diff 跑八遍、打乱顺序,因为顺序会影响结果;后来重构后必须明确告诉它默认不信任代码,否则它会像人一样说“看着没问题,发吧”。
- 直接提交修复,而不是留评论。 只留评论的审查器给人增加了阅读量;直接修掉,只在真正有疑问时留言,人审的就是一个更好的版本。
- 和确定性程序分析配对。 Sonar 的方向是让 agent 负责逻辑和意图,让污点分析、数据流分析负责可以精确计算的部分,供应链扫描负责依赖。
- 循环必须收敛。 这是 Anthropic 团队踩出来的坑:作者 agent 和审查 agent 可以无限互相制造工作。他们有一个 PR 一夜之间经历了五十多轮审查和修复。事后 git blame 发现,审查器反复指出的问题里约 59% 是第一轮就已经存在的旧代码,它不是在发现新 bug,而是“每轮多找出几个旧的”。他们的修正是:把“几轮通过”和召回率一起跟踪;三轮之后要求作者退一步重新考虑方案;前几轮之后只审新增的 diff;按 bug 类别报告,让作者一次修完所有同类问题;已经提过的问题不再重复。
3. 多层检查,但漏洞要错开
多层检查的逻辑类似瑞士奶酪模型:每片奶酪都有洞,叠在一起,洞对齐的概率就很低。但前提是各层的洞不在同一个位置。 按缺陷类别分层,洞天然是错开的:确定性分析管 bug 和安全,agent 审查管逻辑和意图,供应链扫描管依赖。但叠几层用同类模型做的审查,洞很可能是相关的。Voss 转述过一个数据:带着一条看起来无辜的 commit message 的漏洞代码,骗过自动审查器的比例是 88%,骗过人类审查者的是 35%。而“自信地包装起来的坏代码”恰恰是 agent 最擅长产出的东西。层数看起来很多,实际的独立性可能很少。
4. 人看的东西变了
既然读 diff 越来越不产生信息,人的判断就需要换一个对象。两个方向值得注意:
- 往前挪,看边界。 Vercel 的 Guillermo Rauch 把人剩下的工作叫作“验证工程”:在 agent 开工之前,和它约定什么叫正确、性能预算、速度与安全的取舍,把人的注意力花在系统的边界上而不是实现细节上。他还有一条很实用的规则:“只要改了对外 API 的形状,就在 Slack 上通知我。”
- 看行为的 diff,而不是代码的 diff。 Meticulous 的做法是在每个 PR 上回放录制的用户流程,展示所有视觉差异,由审查者判断每个差异是否符合预期。这个审查对象不需要审查者写过相邻模块的上下文。 这两种做法都来自厂商,他们的产品恰好站在自己论证的那一边,但思路本身是通用的:把“这次改动碰了什么”这种不需要深度上下文的形状审查,从那个包揽一切的 approve 按钮里拆出来。
5. “做完了”需要证据
最弱的检查是 agent 自己说“做完了”。另一个容易被忽视的问题是,测试通过只说明它被设计去检查的那部分成立,agent 出于善意也会写出同义反复、或者根本不可能失败的测试。几个来源独立地提出:完成要由一份非作者能核对的记录来证明,比如被测试的确切 commit、验证运行的记录,而不是 agent 的自述。
五、还没有答案的问题
- 发起提示的人算不算审查者? 这是我看到的最直接的分歧。Gitar(现属 Sonar)的 Gautam Korlam 认为不算,因为发起提示的人和 agent 共享上下文,作者与批准者分离要应用到整个创作过程。Anthropic 的做法相反:指挥 agent 的人算作一名必需的审查者,理由是“谁发起了改动,谁就对它负责”,再用风险分档和快速回滚来补偿。两边都没有公布这条规则对漏检率的影响。
- 可维护性怎么验证? 编码 agent 在“让测试通过”上越来越强,在“保持代码库可维护”上几乎没有进步。一种解释是,训练时的奖励只看测试有没有通过,而坏架构的代价要几个月甚至几年才显现。两支独立团队开出的药方一样:把设计前置,目前可维护性只能由人来承担。
- 谁来审查那些检查和审查 agent? Voss 的说法是:验证系统的每一层,在有人决定负责之前,都是没人审查的。
- 风险档什么时候可以降?
- 新人怎么培养出审查判断力? 如果年轻工程师从职业开始就不再自己写相邻模块,他们还能不能审查主干代码?
- 跳过审查的成本去了哪里? 有观点认为它没有消失,只是被推到了下游的事故响应上。
结语
把这些材料放在一起看,“代码审查已死”这个说法既对也误导。死掉的是逐行读 diff 这个动作,不是审查这个职能。审查正在拆分:一部分往前挪到设计和约定阶段,一部分往后挪到行为验证和运行时,中间的大量常规检查交给分层的自动化,人的注意力按风险集中在少数真正重要的地方。 但这张地图的底色是不确定的。证据大多是实践者的自述和厂商的数据,工具和模型每隔几个月就换一代。下一篇我会写我自己目前的思考,包括我如何看待“作者算不算审查者”这个分歧。
References
以下链接对应文中的数据、案例与实践者观点。演讲中的 741% / 30%、Cisco 审查阈值、Bun unsafe 数量和 88% / 35% 由 Laurie Voss 转述,本篇未独立核对其原始研究或代码统计;DHH 案例来自 Wiki 保存的二手转述,附原始访谈链接供追溯。WorkOS 的级联审查是提案,不能当作已验证的部署成果。“实际采用率很低”是我的观察,不是这些材料测出的行业比例。
- DORA, Impact of Generative AI in Software Development (2025 guide, based on the 2024 study)
- Faros Research, The Acceleration Whiplash (2026)
- Faros Research, Ten Takeaways from the AI Engineering Report 2026
- Stack Overflow Developer Survey 2026 — Trust in AI Tools
- GitClear, The Maintainability Gap: AI Code Quality in 2026
- Andrew Stellman, AI Code Review Only Catches Half of Your Bugs
- Laurie Voss, The Death of the Code Review: What the Data Actually Says
- John Kim, How I Review AI Code
- Kun Chen, L8 Principal’s Agentic Engineering Workflow
- Matt Pocock, Fixing the PR Bottleneck
- Addy Osmani, Morgan Westlee Lunt & Qing Wang, How the Claude Code Team Does Code Review
- Nick Nisi, I Made a Fruit Fly Review My Code
- Corey Gallon, I Believe Everything My Agents Tell Me: Three Levels of Review
- Manish Kapur & Addy Osmani, How Anthropic Merges 30,000 Code Changes a Day
- Guillermo Rauch × David Ondrej — interview on agentic engineering
- Gabriel Spencer-Harper, Why AI Didn’t Actually Make You Ship Faster
- Gautam Korlam, Rebuilding CI for AI-Scale Commit Volume
- Dex Horthy, Harness Engineering Is Not Enough: Why Software Factories Fail
- Dex Horthy × Patrick Akil, Why Coding Agents Keep Making Your Codebase Worse
- DHH × Lex Fridman — interview (original episode linked in the Wiki’s secondary account)